이유를 알 수 없는 GPU 에러 정리(device-side assert, CUDA error, CUDNN_STATUS_NOT_INITIALIZED 등등...)
in Devlog / Shoveling on Dl, Troubleshooting
딥러닝 모델 학습에 있어서 빠지면 서러운 GPU는 간혹 알 수 없는 오류를 뿜으며 뻗을 때가 있죠. 이 포스팅에서는 깃허브 이슈 페이지와 스택 오버플로우에서 자주 만날 수 있는 GPU-side 에러들에 대해 알아봅니다.
딥러닝 모델 학습에 있어서 빠지면 서러운 GPU는 간혹 알 수 없는 오류를 뿜으며 뻗을 때가 있죠. 이 포스팅에서는 깃허브 이슈 페이지와 스택 오버플로우에서 자주 만날 수 있는 GPU-side 에러들에 대해 알아봅니다. GPU(특히 CUDA/cuDNN)에서 발생하는 에러는 원인을 특정하기 어렵지만 가장 가능성이 높아 보이는 원인들 위주로 정리해 보았습니다.
저의 경우는 deeplab V3을 돌리면서 device-side assert triggered, CUDNN_STATUS_NOT_INITIALIZED 에러를 굉장히 자주 만났던 것 같네요. Pytorch 환경에서 NVIDIA-smi로 드라이버가 멀쩡히 잡히고, torch.cuda.is_available()도 True가 뜰 경우 시도해 봄직한 리스트를 모아 보았습니다.
device-side assert triggered에러
- GPU단에서 발생하는 OOM에러의 일종이라는 의견](https://github.com/pytorch/pytorch/issues/1204): 해당 유저는 custom loss를 사용 중에 이 에러가 발생했으며, 배치 사이즈를 줄여 해결할 수 있었다고 합니다.
- Loss function은 -1과 255값을 받지 못하기 때문에 발생할 수 있습니다.
- Softmax` 함수에 잘못된 dimension을 넘겨줄 경우에도 발생할 수 있습니다.
- 간혹 학습 기법에 따라 일부러 틀린 라벨을
-1등으로 지정해 넣어주는 경우가 있는데, 이 경우도 문제를 유발할 수 있습니다.
- 간혹 학습 기법에 따라 일부러 틀린 라벨을
- Loss function이 -1과 255값을 받지 못하기 때문에 발생할 수 있습니다.
- 클래스의 인덱스 번호가 1부터 시작하는 경우 발생할 수 있습니다. 가장 발생 가능성이 높은 원인이며, 대개 파이토치에서 문제가 됩니다.
- 클래스 개수가 20개일때 인덱스가 1부터 시작하면
Assertion cur_target >= 0 && cur_target < n_classes가 발생합니다. 따라서 인덱스 범위를 0~19로 수정해 주어야 합니다. - 모델의 아웃풋 벡터가 label vector의 길이와 다를 경우 발생 가능합니다. num_class의 scalar parameter를 데이터셋이 가진 라벨 개수와 맞게 설정해 주었는지 확인해 주세요.
- DeeplabV3과 같은 Segmentation 태스크에서는 구현체에 따라 RGB 3채널로 annotation된 RGB segment map이 클래스 개수 범위로 정규화되며(e.g. 19클래스 0~254
int범위 RGB의 경우 0~1 그레이스케일 범위에서 19 class로 정규화됨.), 따라서 segment annotation 정보를 받아 오는 함수에서 클래스 개수를 적절한 범위로 변경해 주어야 합니다. (e.g.label[label == 255 ] = 19
- 클래스 개수가 20개일때 인덱스가 1부터 시작하면
- Segmentation 태스크에서 자주 발생하는 에러 중 하나로, 모델 prediction과 GT 이미지의 channel order가 다를 경우 발생 가능합니다. PIL image객체는
1 X H X W형식을 가지므로, 채널 순서를1 X H X W으로 변형해 주면 해결할 수 있습니다.a=np.array(1, H, W) a[1]=original[1, :, :]- 또한, 아래 예시 이미지처럼 클래스 개수에 따라 임베딩된 GT 이미지와 모델 아웃풋의 데이터 형태가 다를 경우에도 발생 가능합니다.
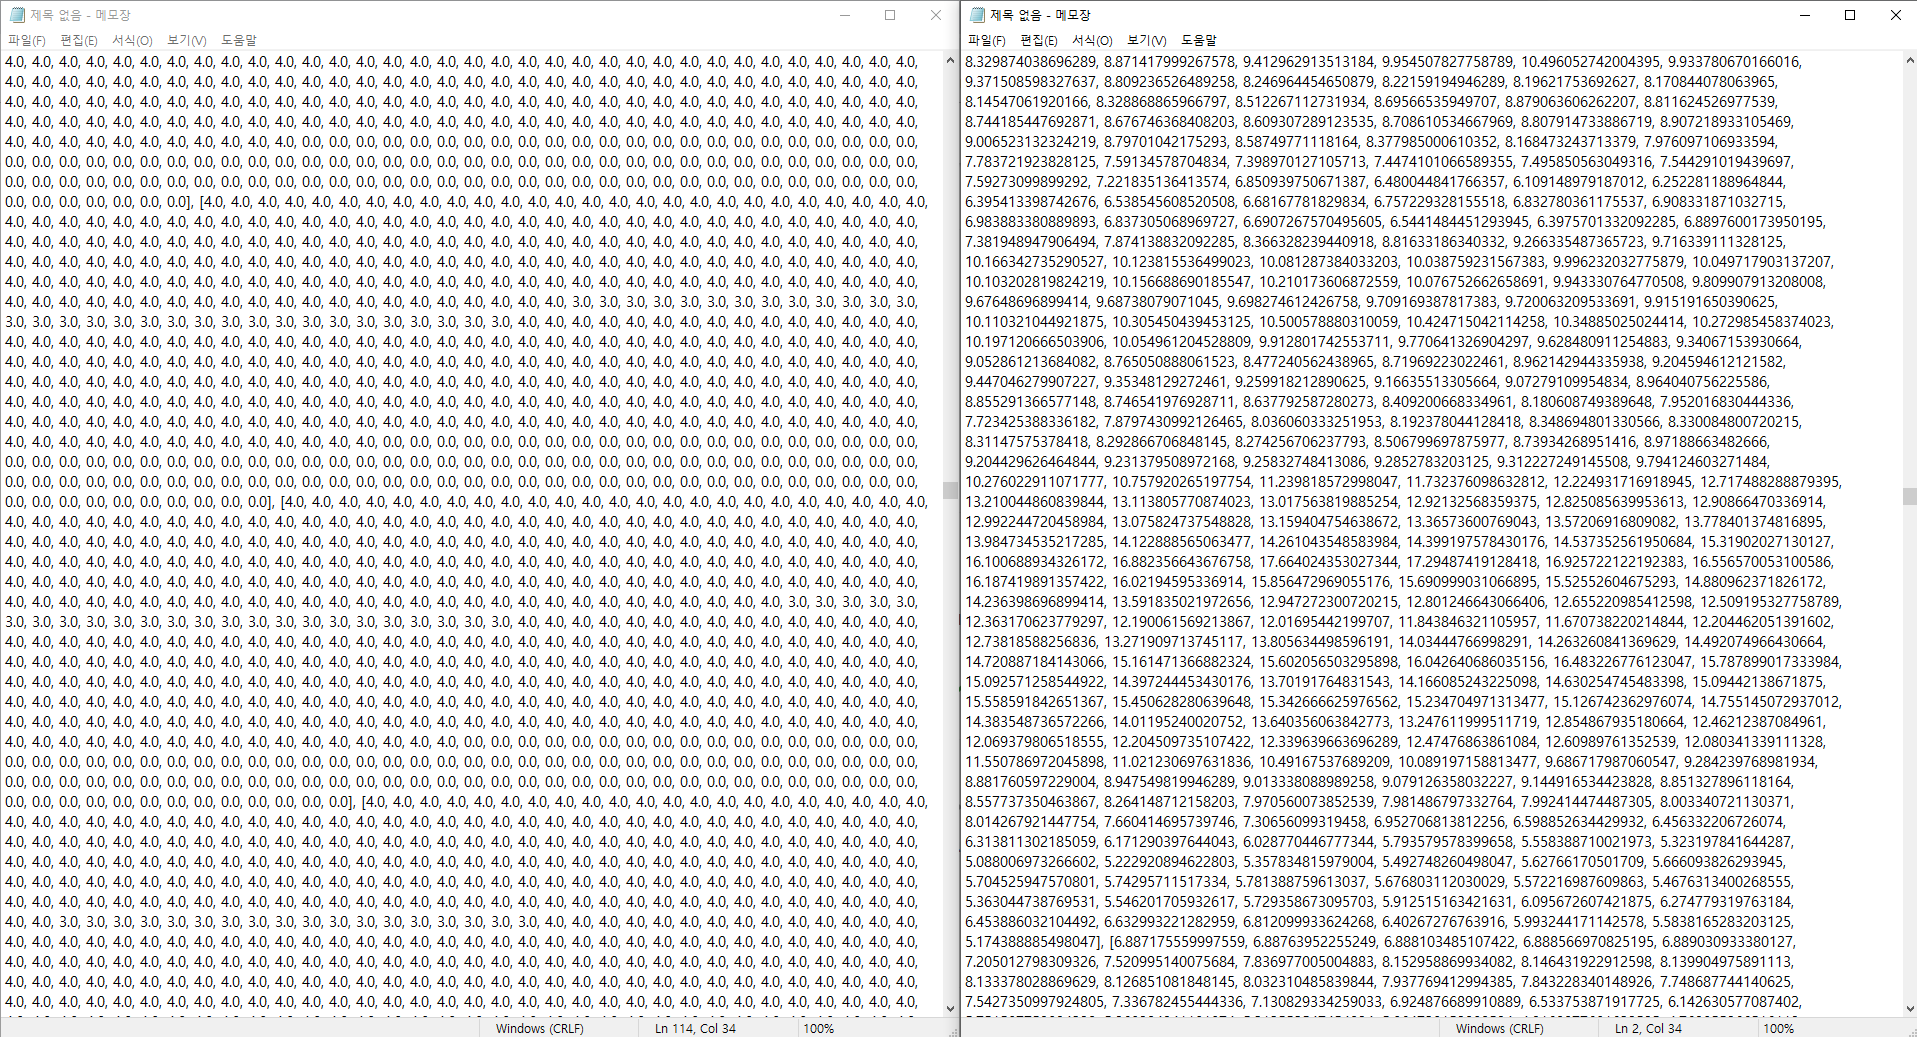
- 구현체에 따라 GT 이미지가 multiple channel인 경우 에러가 발생할 수 있습니다. GT 이미지가 1개의 채널만 갖고 있는 것은 아닌지 확인해 보세요.
- 또한, 아래 예시 이미지처럼 클래스 개수에 따라 임베딩된 GT 이미지와 모델 아웃풋의 데이터 형태가 다를 경우에도 발생 가능합니다.
- 데이터를 처리하는 과정에서
Numpy array와FloatTensor자료형이 충돌함으로 인해 에러가 발생할 수 있습니다. 이러한 상황은 보통 모델 아웃풋에 argmax를 씌워 최종 결과를 내는 과정에서 발생하며,Numpy ndarray를torch.cuda.FloatTensor로 바꾸거나 반대로torch.cuda.FloatTensor를Numpy ndarray로 변환해 연산해 줍니다. 아래는 제가 후자를 위해 애용하는 함수입니다.def to_np(t): return t.cpu().detach().numpy()
CUDNN_STATUS_NOT_INITIALIZED에러
- 딥러닝 환경설정을 하며 굉장히 자주 만나는 에러가 아닐까 싶습니다. 대개 ①CUDA와 cuDNN의 호환성을 무시하고 설치해 버전이 꼬였거나, ②관리자 계정에서 설치를 수행하지 않았거나, ③올바르게 설치한 후 재부팅하지 않아 발생합니다.
- CUDA 버전에 따라 지원되는 드라이버 리스트 : https://docs.nvidia.com/deploy/cuda-compatibility/
- 제품군에 따라 지원되는 드라이버 리스트 : https://www.nvidia.com/Download/Find.aspx?lang=en-us
- “>재부팅 이후에도 동일한 문제가 발생할 경우
$lsmod | grep nvidia으로 로딩된 엔비디아 커널 모듈의 리스트를 모두 확인한 후$sudo rmmod nvidia_drm,$sudo rmmod nvidia_modeset,$sudo rmmod nvidia_uvm,$sudo rmmod nvidia로 프로세스를 강제로 정지합니다. 이후$nvidia-smi를 통해 드라이버를 다시 로드해 봅니다. $rmmod: ERROR: Module nvidia is in use메시지가 나타난 경우$sudo lsof /dev/nvidia*로 프로세스를 kill합니다. (대개 도커때문에 발생)
- CUDA 버전에 따라 지원되는 드라이버 리스트 : https://docs.nvidia.com/deploy/cuda-compatibility/
- Substance designer나 렌더러와 같이 딥러닝 프레임워크와 충돌할 수 있는 CUDA 프로그램을 종료한 후 다시 실행해 봅니다.
GPU에서 발생하는 에러는 그 원인이 정말 다양하기 때문에 끈기를 갖고 디버깅을 해야 합니다. 제 삽질 기록을 통해 누군가가 해답을 얻어 가셨으면 좋겠습니다.